TypeSafe の Jev は「文章を書かないAI」だ——System One モデルという新しい発想
ChatGPT の RLHF を共同発明した Diogo Almeida が 2 年の潜伏を経て公開した Jev。テキストを一切生成せず、型付きの判定と確率だけを返す。70〜500ms・入力 $0.042/MTok という数字の裏側と、誇大広告と疑われた点を整理する。
- AI
- LLM
- TypeSafe
- Jev
- System One
- API
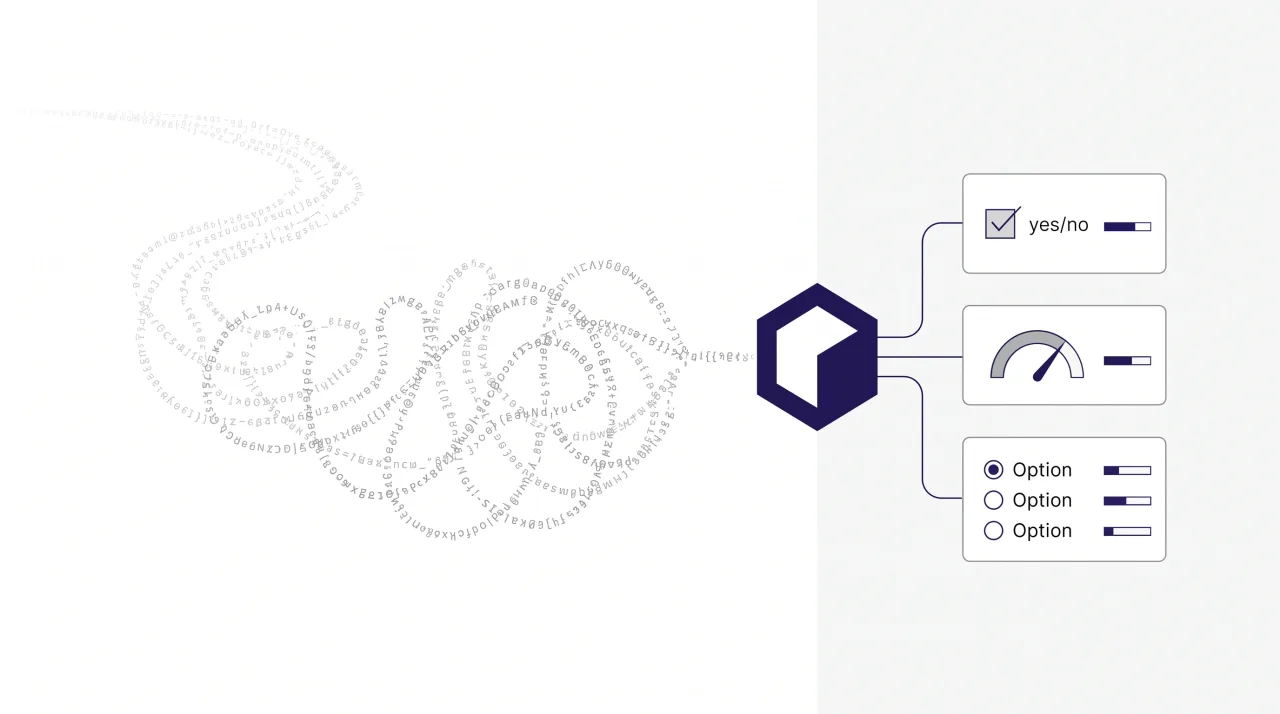
2026 年 9 月 15 日、TypeSafe AI が「Jev」という新しいモデルを発表した。ひとことで言うと、文章を生成しない AI だ。チャットもしないし、コードも書かないし、なぜそう判断したのかも説明しない。プログラムの状態と「型付きの質問」を渡すと、型付きの答えと確率だけが数百ミリ秒で返ってくる。
LLM のニュースには慣れきってしまったが、これは少し毛色が違う。「LLM より賢い」ではなく「LLM がやらされている仕事の一部は、そもそも LLM である必要がなかった」という主張だからだ。実際に触れる範囲(ドキュメントと公開情報)で、何が新しくて、どこまで信じてよいのかを整理してみる。
作ったのは「ChatGPT を作った側の人」
TypeSafe AI の創業者は Diogo Almeida 氏。OpenAI で RLHF(人間のフィードバックによる強化学習)と InstructGPT の研究に関わり、いわゆる「ChatGPT を可能にした技術」の共同発明者として名前が挙がる人物だ。2 年間ステルスで開発し、DCVC がリードする 4,000 万ドルの資金調達とともに Jev を公開した。
Almeida 氏の問題意識は明快で、The Register のインタビューではこう言っている。
if AI is going to fundamentally change how work gets done, people can’t be the only consumers of intelligence.
「AI が仕事のやり方を根本から変えるなら、知能の消費者は人間だけであってはならない」。つまり ソフトウェアが直接消費できる知能 を作りたい、という話だ。
System One モデルとは何か
名前の由来は Daniel Kahneman の『ファスト&スロー』。人間の思考を、速くて直感的な「システム 1」と、遅くて熟慮的な「システム 2」に分ける有名な枠組みだ。
推論モデル(o 系や思考モードつきのフロンティアモデル)はシステム 2 側を追いかけてきた。長い chain-of-thought を書き、自己検証し、その分だけ遅くて高い。一方で、現実のソフトウェアの中で AI に任せたい仕事の多くは、こんなものだ。
- このチケットは billing / technical / other のどれか
- このメッセージは緊急か
- この返金要求はポリシー上許されるか
- この検索結果はクエリにどれくらい関係があるか
どれも「ちょっとした判断」であって、エッセイを書いてほしいわけではない。TypeSafe はここを System One モデル と呼び、公式の定義はこうだ。
System One models are a class of AI models built to make fast, structured decisions that software can use directly.
Jev はその最初のモデルで、現時点ではテキスト入力のみ(文字列、JSON オブジェクト、テキスト配列)。画像や音声はまだ扱えない。
3 つのプリミティブしか返さない
Jev が返せるのは 3 種類の答えだけだ。ドキュメントではこれを プリミティブ と呼んでいる。
| プリミティブ | 何を返すか | 例 |
|---|---|---|
| Choice | 定義した選択肢から 1 つ + 全選択肢の確率分布 | billing: 0.85, technical: 0.08, other: 0.07 |
| Noul | yes/no の「yes である確率」 | 0.999 |
| Score | 順序づけたレベルに対する確率加重の位置 | 0〜2 のスケールで 1.4 |
Noul という耳慣れない名前の由来はドキュメントにも書かれていないが、要するに確率つきの真偽値だ。
重要なのは、答えの空間を開発者が先に定義する という点。モデルは定義された選択肢の外には出られないので、スキーマから外れた出力は構造的に起きない。TypeSafe が「ハルシネーションしない」と言うときの意味はこれで、「型エラーが数学的に 0%」という主張だ(この言い方への批判は後述する)。
実際の API はかなりシンプル
エンドポイントは 1 本だけ。POST https://api.typesafe.ai/v1/systemone に、state(判断材料)、model、questions(型付き質問のマップ)を投げる。
curl -X POST https://api.typesafe.ai/v1/systemone \
  -H "Authorization: Bearer $TYPESAFE_API_KEY" \
  -H "Content-Type: application/json" \
  -d @- <<'JSON'
{
  "state": "Hi, I've been trying to connect my Stripe account for 3 days and it keeps failing. I'm losing sales. Please help ASAP.",
  "model": "jev-latest",
  "questions": {
    "urgency": {
      "type": "noul",
      "instructions": "Does this message express urgency?"
    }
  }
}
JSON
レスポンスはこうなる。
{
  "model": "jev-latest",
  "answers": {
    "urgency": { "type": "noul", "noul": 0.999 }
  },
  "usage": { "input_tokens": 312, "output_tokens": 48 }
}
JavaScript SDK(@typesafe-ai/sdk)だとこう書ける。
import { choice, TypeSafeClient } from "@typesafe-ai/sdk";

const client = new TypeSafeClient();
const response = await client.systemOne({
  state: { document: "I was charged twice. Please fix this ASAP." },
  questions: {
    category: choice("What is this ticket about?", {
      billing: null,
      technical: null,
      other: null,
    }),
  },
});

console.log(response.answers.category.choice);
プロンプトエンジニアリングという概念がほぼ消えているのが分かると思う。「何を判断させるか(instructions)」と「答えの選択肢や基準(criteria)」を書くだけで、出力フォーマットの指示も JSON パースの try/catch も要らない。
設計のキモは「質問を並列に投げる」こと
ドキュメントが繰り返し強調しているのは、1 つの質問に複数の判断を詰め込むな ということだ。「返金すべきか」という広い質問は、「返金を要求しているか」「二重請求の証拠があるか」「ポリシー上返金可能か」という独立した 3 つの Noul に分解する。
分解した質問は 1 リクエストにまとめて投げると、モデルが state を 1 回だけ読み込み、すべての質問を 並列に 評価する。質問同士はお互いの答えを見られない。その代わり、答えの組み合わせ方(重み付け、閾値、エスカレーション条件)はすべてコード側に残る。
これは要するに「ワークフローの制御はコード、意味の理解だけモデル」という分業で、エージェントに丸投げする設計とは正反対だ。個人的には、この割り切りがいちばん好きなところだった。
確率をそのまま使える
Choice と Score には confidence(0〜1)が付いてくる。確率分布が 1 つに集中していれば高く、ばらけていれば低い。ドキュメントの推奨は大まかに、0.9 超なら自動処理、0.5 未満なら人間にエスカレーション、その間は確認を挟む、というもの。ただし「閾値は 1 つの数字ではない」とも書いてあって、口座情報の表示と送金の承認で同じ閾値を使うな、という当たり前だが大事な注意がある。
Noul には confidence が付かない。0.5 付近は「中くらいの強さ」ではなく「yes と no が同じくらいの確率」という意味なので、そこは読み間違えやすい。
速さと安さの数字
TypeSafe が公表している数字はこうだ。
| 項目 | Jev | 比較対象(フロンティア LLM) |
|---|---|---|
| レイテンシ(end-to-end) | 70〜500 ms | 3〜329 秒 |
| 入力トークン単価 | $0.042 / MTok | GPT-5.6 Terra: $2.00 / MTok |
| 出力トークン単価 | 無料 | GPT-5.6 Terra: $12 / MTok |
| 社内ワークフロー評価での優位 | 193.6 倍速く 444.6 倍安い(ピーク値) | — |
出力が無料なのは、出力トークンを逐次生成していないからだ。公式ブログによれば、3 つの技術要素がある。
- 構造化出力に最適化した新しいモデルアーキテクチャ
- トークンを 1 つずつ吐くのではなく、すべての答えを同時に生成する parallel sampler
- RLHF ならぬ RLCD(Reinforcement Learning for Calibrated Decisions)——確率が「正直」になるように、結果に対して較正する訓練
デモとしては、構造化されたゲーム状態を入力に Jev が Doom を反応的にプレイする動画が出ている(秒間 10 クエリで時給約 7 ドル)。画面には Jev の 0.114 秒に対し GPT-5.6 Terra の 8.566 秒という応答時間が並んでいた。もう 1 つ、Wikipedia のリンクを 255 択から選び続けて目標ページに辿り着く Wikiracing のデモもある。
現行モデルは jev-1.13.0(jev-latest と jev-preview は現時点で同じもの)。1 リクエスト 64k トークン、state と最長の質問を合わせて 32k まで。レート制限は 250k tokens/sec・1,200 req/min とあるが「需要が多く動的に調整中」らしい。学習の主言語は英語で、日本語の精度は自分で検証する必要がある。
「誇大広告では」という批判も正当だ
ここまで読むと出来すぎに見えるので、批判側の論点も並べておく。Hacker News のスレッドは 475 コメントを超え、今週いちばん鋭い技術議論になった。
ベンチマークが自作・自己採点。193.6 倍 / 444.6 倍という数字は TypeSafe の capabilities チームが作った 4 つのワークフローで測ったもので、しかも正解ラベルは「GPT-6 Astra と Claude Fable 5.1 の答えの平均」だ。独立した ground truth ではなく、他社モデルとの一致率を測っている。精度は約 67.8% で「GPT-5.6 Terra と同等」とされるが、第三者による再現はまだない。レイテンシも「西海岸のラップトップから計測」と脚注にあり、LLM 側が chain-of-thought をフルに書いている条件と比べれば当然速い。
「ハルシネーションしない」の意味が狭い。スキーマ通りの出力が返ることと、答えが正しいことは別だ。Almeida 氏自身も HN で「confidently wrong になることはあり得る」と認めている。The Register も「構造化出力と自然言語の信頼性は比較になっていない」と指摘した。
「新しいモデルクラス」なのか、ゼロショット分類器なのか。HN では BERT/DeBERTa 系のエンコーダ分類器、GLiNER、grammar-constrained decoding とロジット由来の confidence、conformal prediction、DSPy の typed signature など、既知の技術と重ねる指摘が数時間で並んだ。「要はゼロショット分類器では」というコメントに Almeida 氏が「exactly right!」と返したのは、フロンティアモデルを名乗る launch としては率直すぎる譲歩だと受け取られた。
価格は補助されていないのか。TypeSafe 自身が「補助でないことは証明できない。持続可能性は長期で示すしかない」と書いている。
一方で、Every による独立テストは 1 つの抽出タスクで Jev が Claude Fable 5.1 より約 25 倍速く(1 パッセージあたり 0.35 秒 vs 8.83 秒)、約 580 倍安いという結果を出しており、方向性としての主張は裏付けられている。倍率が公称ほどではないのも、まあそうだろうという感じだ。
苦手なことはドキュメントに正直に書いてある
好感が持てるのは、モデルの「ジャギー(得意不得意のデコボコ)」を専用ページで公開している点だ。Jev 1.13 で挙がっているのは次のようなもの。
- 指示を字義通りに読む。含意を汲まないので、境界条件は明示する
- 算術・カウントができない。「答えの形を認識している」だけで数えていない。計算はコードで
- 16 進数や RGB のような数値表現に弱い。色名など名前つきカテゴリに変換してから渡す
- 日付の比較ができない。日付をテキストとして読むので、順序や期間の判定はコードで
- 多段の間接参照・二重否定で精度が落ちる
- 無関係な state が多いと気が散る。コードで絞ってから渡す
- 敵対的な入力を疑わない。プロンプトインジェクションに素直に従う可能性がある
- 構造的な不変条件が成り立たない。P(noul) と 1 − P(not noul) は一致しない。別々の質問間で算術的な同一性を仮定しないこと
- 生成はできない。抽出したいなら候補をコードで列挙して選ばせる
まとめると「判断だけ Jev に、計算・パース・抽出はコードに」という原則だ。LLM に慣れた身だと、日付比較すら任せられないのは不便に感じるかもしれない。しかし、それをコードでやれば 決定論的に正しい のだから、本来そうあるべきとも言える。
どこに使えそうか
自分のユースケースで考えると、これが刺さりそうな場所はかなりある。
- 問い合わせの一次振り分け。カテゴリ・緊急度・感情スコアを 1 リクエストで取って、confidence が低いものだけ人間へ
- 検索やレコメンドの rerank。候補ごとに関連度 Score を取って並べ替える。1 件あたりのコストが実質ゼロに近い
- コンテンツモデレーション。ラベルごとに Noul を立て、「1 つでも重大違反なら止める」というルールはコードで書く
- エージェントのガードレール。LLM が出した行動計画を Jev で「ポリシーに反するか」「ユーザーの依頼と矛盾しないか」と検査する。推論モデルの前段・後段に置く System 1 として
逆に、文章を書く、要約する、コードを書く、といった仕事は最初から対象外だ。Jev は LLM を置き換えるのではなく、LLM に頼んでいた「判断だけの仕事」を引き受ける モデルと捉えるのが正しい。
まとめ
Jev の本質は、モデルの新しさそのものより、「AI に何を任せ、何をコードに残すか」の線引きを API の形で強制してくること にあると思う。答えの空間を先に決め、判断を原子的に分解し、確率をそのままコードで扱う。この設計に従うと、自然と「LLM に丸投げしない」構造になる。
数字は割り引いて読むべきだし、日本語での精度も、価格の持続性も、まだ誰も証明していない。現時点では早期アクセス(ウェイトリスト)で、順次開放中とのこと。それでも、「文章を書かない AI」という切り口が、AI をソフトウェアの部品として扱う流れの中で 1 つの参照点になるのは間違いなさそうだ。
参考リンク
- Introducing System One Models & Jev(TypeSafe AI 公式ブログ)
- TypeSafe Docs: System One / Models / Confidence / Jev 1.13 の限界
- TypeSafe AI debuts model for machines that plays Doom(The Register)
- Jev by TypeSafe AI: Is the 200x Faster Decision Model Too Good to Be True?(Flowtivity)
- AINews: Jev, a “System One Model”(Latent Space)